
Robots des IA dans vos journaux : qui lit votre site.
Les robots des IA lisent votre site, souvent la nuit, et n'apparaissent jamais dans votre tableau de bord d'audience. Le seul endroit où on les voit passer, c'est le journal de votre serveur. Voici comment le lire, et pourquoi être crawlé ne veut pas dire être cité.
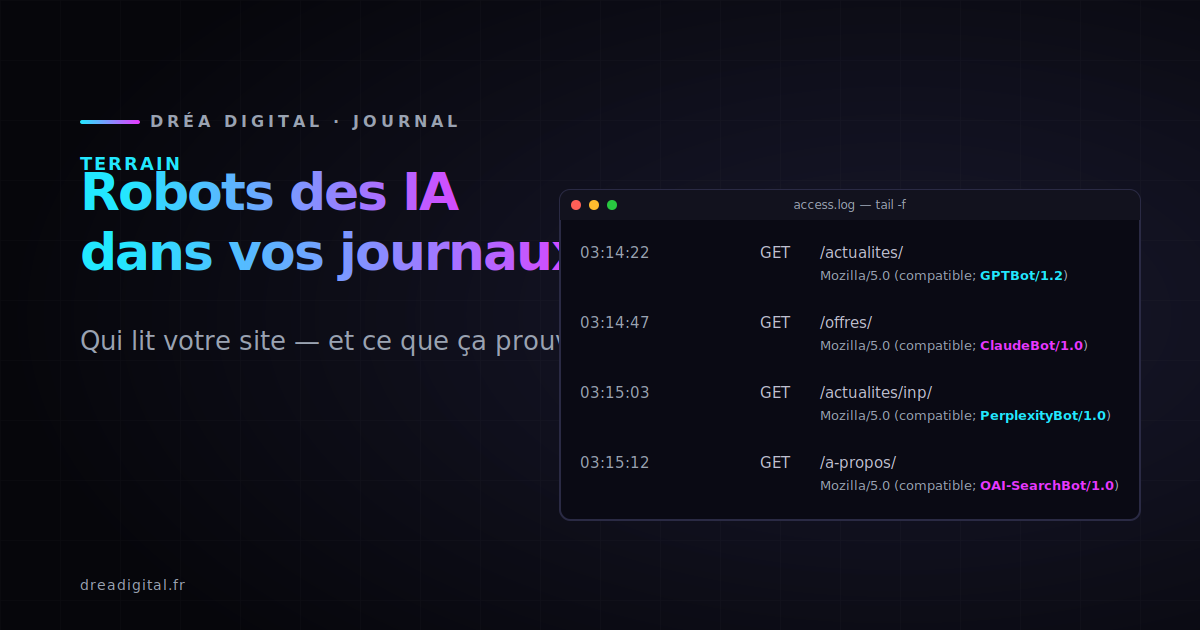
Il est trois heures du matin et personne ne travaille. Pourtant, dans le journal du serveur, une ligne s'inscrit : une machine vient de demander une page, puis une autre, méthodiquement. Elle ne clique sur rien, ne remplit aucun formulaire, ne verra jamais la bannière soignée en haut de page. Elle lit. Et quand on regarde son nom, ce n'est ni Google ni un visiteur : c'est un robot d'IA.
Ces passages, la plupart des dirigeants ne les voient pas. Le tableau de bord d'audience affiche les humains, pas les robots. Il faut ouvrir un fichier plus discret, le journal d'accès du serveur, celui qui note chaque requête avec l'heure et le nom du demandeur. Depuis un an, ce fichier raconte une histoire nouvelle, et je trouve qu'elle mérite qu'on s'y arrête cinq minutes.
Qui sont ces visiteurs qui ne visitent pas
Ils portent des noms qui reviennent : GPTBot, celui d'OpenAI. ClaudeBot, celui d'Anthropic. PerplexityBot. Et quelques autres au nom plus explicite : OAI-SearchBot, ChatGPT-User, Claude-SearchBot. Chacun laisse sa signature dans le journal, une chaîne de caractères qu'on appelle l'agent utilisateur, et que son éditeur publie noir sur blanc dans sa documentation.
Ce qui compte, c'est qu'ils ne font pas tous la même chose, et cette nuance change tout. Il faut distinguer trois gestes qu'on confond presque toujours. Être aspiré pour entraîner un modèle, d'abord : c'est le travail de GPTBot ou de ClaudeBot, qui récoltent du texte pour nourrir la prochaine version du modèle. Être récupéré en direct pour répondre à une question posée maintenant, ensuite : c'est le rôle d'OAI-SearchBot ou de PerplexityBot, qui vont chercher une page parce qu'un utilisateur, à l'instant, attend une réponse. Et être archivé, enfin, par des robots comme celui de Common Crawl, une bibliothèque publique où beaucoup de modèles viennent se servir.
Trois gestes, trois robots différents, et une conséquence contre-intuitive : bloquer GPTBot ne vous retire pas des réponses de ChatGPT. Le robot qui alimente ces réponses en direct, ce n'est pas lui. On peut donc refuser de nourrir l'entraînement d'un modèle tout en restant citable dans ses réponses, ou l'inverse. Ce sont deux décisions séparées, prises dans deux lignes différentes d'un même petit fichier, le robots.txt.
Ce que le journal prouve, et ce qu'il ne prouve pas
Voir passer OAI-SearchBot sur votre page, c'est agréable. Ça veut dire qu'au moins une fois, une IA est venue chercher chez vous de quoi construire une réponse. Mais je préfère être clair sur la limite, parce que c'est là qu'on se raconte des histoires : une visite dans le journal n'est pas une citation. Le robot est passé, il a lu, et rien ne dit que votre page a fini dans la réponse affichée à l'utilisateur. Entre la lecture et la citation, il y a des filtres de qualité, un choix de sources, une mise en forme. Beaucoup de pages lues ne ressortent jamais.
Il y a une deuxième limite, plus embêtante. Le nom qu'un robot inscrit dans le journal, il le choisit lui-même. Un script mal intentionné peut se présenter comme GPTBot sans être GPTBot. Les grands éditeurs publient les plages d'adresses depuis lesquelles leurs vrais robots opèrent, ce qui permet de vérifier, mais tant qu'on ne fait pas cette vérification, une ligne dans le journal reste un indice, pas une preuve. Le robots.txt fonctionne pareil : c'est une convention que les robots sérieux respectent, pas une barrière technique. Il demande poliment, il n'empêche pas.
Une visite dans le journal n'est pas une citation. Un nom dans le journal n'est pas une preuve. Deux distinctions qui évitent beaucoup d'illusions.
Le lien avec ce que Google vous montre déjà
Depuis le 31 août 2026, Google a généralisé dans le monde entier un rapport de la Search Console qui mesure vos apparitions dans les réponses IA, les AI Overviews et le Mode IA. C'est une bonne chose, et je l'avais détaillé ici même. Mais ce rapport ne couvre qu'un côté du décor : celui de Google. Il ne dit rien de ChatGPT, de Claude ou de Perplexity, qui ont chacun leurs propres robots et ne rendent de comptes à personne. Le journal de votre serveur, lui, les voit tous passer. C'est la seule fenêtre que vous possédez vraiment, sur votre propre machine, sans dépendre d'un tableau de bord prêté par un tiers.
Un quart d'heure pour regarder chez vous
Vous n'avez pas besoin d'un outil payant pour commencer. La plupart des hébergements donnent accès aux journaux d'accès, souvent dans un dossier nommé logs, parfois via une console fournie par l'hébergeur. Voici ce que je conseille de faire, dans l'ordre :
- Ouvrir le journal d'accès récent et chercher les noms
GPTBot,ClaudeBot,OAI-SearchBot,PerplexityBot. Leur présence, ou leur absence, vous dit déjà si les IA connaissent votre site. - Ouvrir votre
robots.txt(il est à l'adresse votre-domaine, suivi de/robots.txt) et lire ce qu'il autorise. Beaucoup de sites en ont un sans savoir ce qu'il contient, parfois hérité d'un ancien prestataire. - Décider, une bonne fois, ce que vous voulez : rester lisible par les IA qui citent, refuser celles qui entraînent, ou tout accepter. Il n'y a pas de réponse universelle, ça dépend de ce que vous vendez et de qui vous cite.
Si vous préférez un premier état des lieux sans ouvrir vous-même les fichiers, notre scanner SEO donne un aperçu de ce que les moteurs et les IA voient de votre site. Mais le geste de fond reste le même.
Ce dernier point est le vrai travail, et il n'est pas technique. Un artisan qui vit du bouche-à-oreille local n'a pas les mêmes intérêts qu'un cabinet qui veut être la source citée sur son sujet. Le premier gagne peu à être aspiré par un modèle mondial. Le second a tout à gagner à être la page qu'une IA va chercher quand on l'interroge sur son métier.
Ce que ça ne remplace pas
Regarder ses journaux ne remplace pas un contenu qui mérite d'être cité. Un robot peut passer tous les jours : s'il ne trouve chez vous que trois lignes floues sur votre activité, il ne vous citera pas davantage. La visibilité dans les IA se joue d'abord sur ce que vous écrivez, ensuite seulement sur qui vous laissez entrer. Mais commencer par ouvrir le journal, c'est arrêter de deviner. C'est voir, de ses yeux, qui lit son site la nuit, et reprendre une décision qu'on laissait par défaut à un fichier que personne n'avait rouvert depuis des années. C'est aussi l'un des points qu'on regarde ensemble dans un accompagnement, une fois que le contenu, lui, mérite d'être cité.
Questions fréquentes
Comment savoir si des robots d'IA lisent mon site ?
En ouvrant le journal d'accès de votre serveur, souvent dans un dossier logs ou via la console de votre hébergeur, et en y cherchant des noms comme GPTBot, ClaudeBot, OAI-SearchBot ou PerplexityBot. Leur présence signale que des IA sont venues lire vos pages.
Bloquer GPTBot me retire-t-il des réponses de ChatGPT ?
Non. GPTBot sert à l'entraînement des modèles d'OpenAI. Les réponses de ChatGPT sont alimentées en direct par d'autres robots, OAI-SearchBot et ChatGPT-User. Bloquer l'un ne touche pas l'autre : entraînement et citation sont deux réglages distincts.
Être crawlé par une IA garantit-il d'être cité ?
Non. Voir un robot passer dans vos journaux prouve seulement qu'une page a été lue. Entre la lecture et la citation, il y a des filtres de qualité et un choix de sources. Beaucoup de pages lues ne sont jamais reprises dans une réponse.
Sur le même sujet : mesurer sa visibilité dans les réponses IA avec la Search Console, et l'AI Act et la transparence des chatbots.
Quels robots lisent votre site cette semaine ?
Ouvrez le journal d'accès de votre hébergeur, cherchez GPTBot, ClaudeBot, OAI-SearchBot et PerplexityBot. Envoyez-moi ce que vous trouvez (ou n'y trouvez pas), je vous dis si votre robots.txt laisse passer ce que vous voulez laisser passer.